






|
Кількість
|
Вартість
|
||
|
|
|||
|
|
|||
Комп'ютер для ШІ (AI Workstation) — робоча станція, у якій головний параметр — обсяг відеопам'яті: від нього залежить, яку нейромережу можна запустити локально і наскільки швидко вона працюватиме. У каталозі PowerUp — AI-станції з однією, двома або трьома відеокартами та сумарно до 192 ГБ відеопам'яті: NVIDIA RTX PRO Blackwell, GeForce RTX 50, NVIDIA RTX A, Quadro RTX та Intel Arc Pro. Процесори — від Core Ultra і Ryzen 9 до Threadripper PRO 9000, Xeon W і AMD EPYC, оперативна пам'ять — від 32 до 256 ГБ. Кожну станцію 4 години тестуємо під навантаженням, гарантія — 24 місяці.
Скільки відеопам'яті потрібно під задачу
Обираючи ПК для ШІ, відштовхуйтеся від моделі: вона має повністю поміститися у відеопам'ять, інакше швидкість падає в рази. Для мовних моделей (LLM) розрахунок простий: у 4-бітному квантуванні потрібно близько 0,6 ГБ на 1 млрд параметрів, у 8 бітах — близько 1,1 ГБ, у FP16 — 2 ГБ, плюс 10–20% на контекст.
| Відеопам'ять у системі | Що запускається локально | Конфігурації в каталозі |
|---|---|---|
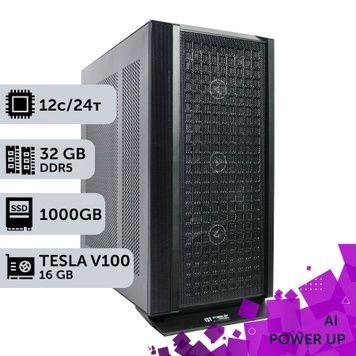
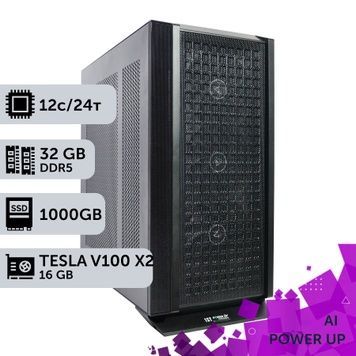
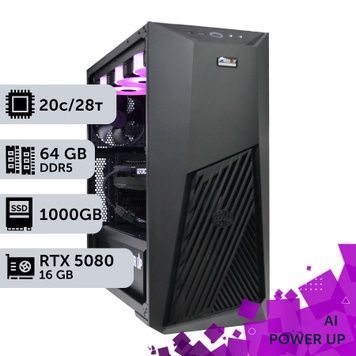
| 16 ГБ | LLM на 7–14 млрд параметрів у 4 бітах, Stable Diffusion XL, Flux у FP8 | GeForce RTX 5080, Tesla V100 16 ГБ |
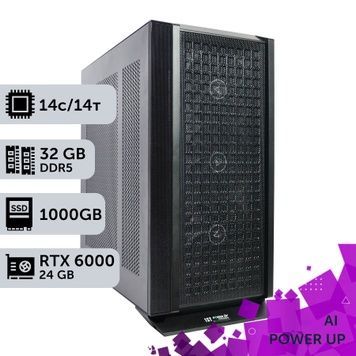
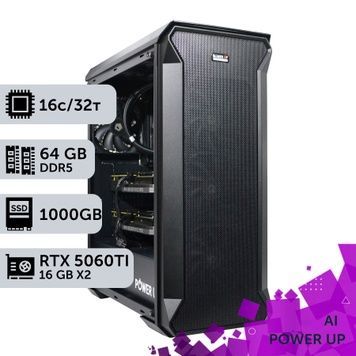
| 24–32 ГБ | LLM до 32 млрд у 4 бітах, 14 млрд у 8 бітах, генерація зображень у Flux | GeForce RTX 5090 32 ГБ, Quadro RTX 6000 24 ГБ, Arc Pro B60 24 ГБ, 2× RTX 5060 Ti 16 ГБ, 2× RTX 5070 Ti, 2× RTX A4000, 2× RTX PRO 2000 Blackwell |
| 40–48 ГБ | LLM близько 70 млрд у 4 бітах, 32 млрд у 8 бітах | RTX PRO 5000 Blackwell 48 ГБ, 2× RTX PRO 4000 Blackwell, 2× Arc Pro B60, 2× RTX A5000, 2× Quadro RTX 6000, 2× RTX A4500, 3× RTX 5060 Ti 16 ГБ, 3× RTX A4000 |
| 72–96 ГБ | LLM 70 млрд у 8 бітах (потрібно 96 ГБ), MoE-моделі на 100–120 млрд у 4 бітах, LoRA-донавчання моделей до 30 млрд | 2× RTX PRO 5000 Blackwell (96 ГБ), 3× RTX PRO 4000 Blackwell (72 ГБ), 3× Arc Pro B60 (72 ГБ) |
| 192 ГБ | LLM 70 млрд у FP16, MoE-моделі на 200 млрд і більше у 4 бітах, повне донавчання моделей на 7–8 млрд | 2× RTX PRO 6000 Blackwell 96 ГБ |
Відеокарти в AI-станціях
| Відеокарта | Пам'ять на карту | Архітектура | Для чого підходить |
|---|---|---|---|
| NVIDIA RTX PRO 6000 Blackwell | 96 ГБ GDDR7 з ECC | Blackwell | Найбільші моделі на одній карті, донавчання, робота 24/7 |
| NVIDIA RTX PRO 5000 Blackwell | 48 ГБ GDDR7 з ECC | Blackwell | LLM на 70 млрд параметрів на одній карті |
| NVIDIA RTX PRO 4000 / 2000 Blackwell | 24 / 16 ГБ GDDR7 з ECC | Blackwell | Збірки з 2–3 карт: 4000 займає один слот, 2000 споживає 70 Вт |
| GeForce RTX 5090 | 32 ГБ GDDR7 | Blackwell | Найшвидший інференс і генерація зображень за свої гроші |
| GeForce RTX 5060 Ti 16 ГБ / 5070 Ti / 5080 | 16 ГБ GDDR7 | Blackwell | Недорогий вхід у ШІ, збірки з 2–3 карт |
| NVIDIA RTX A5000 / A4500 / A4000 | 24 / 20 / 16 ГБ GDDR6 з ECC | Ampere | Інференс і донавчання, перевірені драйвери |
| Quadro RTX 6000 / RTX 5000 | 24 / 16 ГБ GDDR6 | Turing | Інференс LLM з великим обсягом пам'яті за менші гроші |
| Intel Arc Pro B60 / B50 | 24 / 16 ГБ GDDR6 | Battlemage | Інференс через OpenVINO, PyTorch і llama.cpp, найдешевша відеопам'ять |
| Tesla V100 | 16 ГБ HBM2 | Volta | Наукові розрахунки з подвійною точністю (FP64), навчання класичних моделей |
NVIDIA підтримує CUDA, тому на ній працює практично весь софт для ШІ. Blackwell (RTX PRO і RTX 50) пришвидшує обчислення у FP4 і FP8. Turing і Volta не підтримують BF16 і FlashAttention 2: для інференсу вони підходять, для навчання сучасних моделей краще Ampere і Blackwell. Intel Arc Pro дає більше пам'яті за ті самі гроші, але програми, написані лише під CUDA, на ній не запустяться. Різниця між поколіннями професійних карт — у статті про лінійку професійних відеокарт NVIDIA, а чому в GeForce RTX 50 мало пам'яті, пояснюємо в окремому розборі.
Одна потужна відеокарта чи кілька
- Мовні моделі — Ollama, llama.cpp і vLLM ділять модель між картами, тому 2× 24 ГБ дають змогу запустити модель, якій потрібно 48 ГБ. Одна карта з тим самим обсягом пам'яті зазвичай генерує текст швидше: дані не ходять між картами через PCIe.
- Генерація зображень — Stable Diffusion і ComfyUI рахують одне зображення на одній карті. Кілька карт дають кілька паралельних задач, але не складають пам'ять.
- Навчання — кілька карт помітно пришвидшують навчання, якщо модель поміщається в пам'ять кожної карти. Без NVLink приріст нижчий, ніж кількість карт.
- Зв'язок між картами — у RTX PRO Blackwell і GeForce RTX 50 немає NVLink, обмін іде через PCIe, тому для 2–3 карт важлива кількість ліній PCIe у процесора.
Процесор і платформа
| Платформа | Ліній PCIe у процесора | Каналів пам'яті | Відеокарт у наших збірках | Коли обирати |
|---|---|---|---|---|
| Core Ultra 5/7, Core i5/i7 14-го покоління, Ryzen 9 7900X/9900X/9950X | 20–24 | 2 × DDR5 | 1–2 | Інференс на 1–2 картах, генерація зображень |
| Threadripper 3970X | 64 PCIe 4.0 | 4 × DDR4 | 2–3 | Три карти за доступною ціною |
| AMD EPYC 7551, 7F52, 7F72, 7C13 | 128 PCIe 3.0/4.0 | 8 × DDR4 ECC | 2–3 | Багато ліній і пам'яті за менші гроші |
| Threadripper PRO 9955WX–9995WX | 128 PCIe 5.0 | 8 × DDR5 ECC | 2–3 | Флагманські станції з RTX PRO 5000/6000 Blackwell |
| Xeon w5-3423, w9-3475X | 112 PCIe 5.0 | 8 × DDR5 ECC | 2–3 | Три карти на платформі Intel, до 256 ГБ пам'яті |
На настільних Core і Ryzen дві карти зазвичай працюють у режимах x8/x8 або x16/x4. На Threadripper PRO, Xeon W і EPYC кожна карта отримує свої 16 ліній. Вісім каналів пам'яті важливі, коли частина великої моделі вивантажується в оперативну пам'ять, — детально в статті про канали пам'яті на робочій станції. Чим серверні EPYC на кшталт 7C13 відрізняються від роздрібних, розповідаємо в огляді OEM-версій EPYC.
Оперативна пам'ять, диски і програми
- Оперативна пам'ять — не менше за сумарну відеопам'ять: модель спочатку зчитується в ОЗП. У наших збірках від 32 до 256 ГБ, обсяг можна збільшити під час замовлення.
- SSD NVMe від 1 ТБ — модель на 70 млрд параметрів у 4 бітах займає близько 40 ГБ, датасети й контрольні точки навчання — сотні гігабайт. У збірках стоять SSD на 1–4 ТБ.
- Програми — Ollama, LM Studio, llama.cpp і vLLM для мовних моделей, ComfyUI і Stable Diffusion для зображень, PyTorch і TensorFlow для навчання. vLLM офіційно працює лише в Linux, решта запускається і в Windows.
Для цілодобового сервісу без монітора, наприклад внутрішнього чат-бота компанії, перегляньте серверні ПК. Збірки з однією GeForce RTX 50 для роботи зібрані в розділі комп'ютерів на RTX 50-ї серії, інші лінійки — у каталозі робочих станцій.
Перевірка, гарантія, доставка й оплата
- Тест — кожну станцію 4 години навантажуємо в AIDA64 і FurMark. Для перевірки встановлено неактивовану Windows 10/11, ліцензійний ключ можна придбати окремо.
- Своя конфігурація — змінюємо обсяг пам'яті, кількість і модель відеокарт, процесор у межах платформи та накопичувачі. Станцію під вашу модель зберемо через індивідуальну конфігурацію.
- Гарантія 24 місяці — ремонт у середньому 1–2 дні плюс доставка, на цей час є підмінний фонд. Умови гарантії.
- Доставка й оплата — Новою поштою по Україні за 1–3 дні, самовивіз з офісу в Києві з перевіркою перед оплатою. Оплата на розрахунковий рахунок без комісії, безготівкою з ПДВ або частинами від ПриватБанку та ПУМБ до 6 місяців. Детальніше — на сторінці оплати й доставки.
Часті питання про комп'ютери для ШІ
Скільки відеопам'яті потрібно, щоб запустити мовну модель локально?
Помножте кількість параметрів у мільярдах на 0,6 ГБ для 4-бітного квантування, на 1,1 ГБ для 8 біт або на 2 ГБ для FP16 і додайте 10–20% на контекст. Моделі на 14 млрд параметрів у 4 бітах вистачить 16 ГБ, на 32 млрд — 24 ГБ, на 70 млрд — 48 ГБ, а для 70 млрд у 8 бітах потрібно 96 ГБ.
Що краще для ШІ: GeForce RTX 5090 чи RTX PRO Blackwell?
RTX 5090 з 32 ГБ дає максимальну швидкість за свої гроші, якщо модель поміщається в цю пам'ять. RTX PRO 5000 і 6000 Blackwell дають 48 і 96 ГБ на карту, пам'ять з ECC і драйвери для роботи 24/7 — їх обирають для моделей на 70 млрд параметрів і більше та для станцій з кількох карт.
Чи можна скласти відеопам'ять кількох відеокарт?
Для мовних моделей — так: Ollama, llama.cpp і vLLM розподіляють модель між картами, і дві карти по 24 ГБ працюють з моделлю на 48 ГБ. Для Stable Diffusion і ComfyUI — ні: одне зображення рахується на одній карті, а кілька карт дають змогу запускати задачі паралельно.
Чи підходить Intel Arc Pro B60 для нейромереж?
Так, для інференсу: 24 ГБ відеопам'яті коштують дешевше, ніж у NVIDIA, а моделі запускаються через OpenVINO, PyTorch і llama.cpp. Обмеження одне: програми, які працюють лише на CUDA, на Intel Arc не запустяться, тому для навчання й нестандартного софту надійніша NVIDIA.
Чим відрізняються відеокарти RTX 6000?
Під цією назвою випущено чотири різні карти: Quadro RTX 6000 (Turing, 24 ГБ GDDR6), RTX A6000 (Ampere, 48 ГБ), RTX 6000 Ada (48 ГБ) і RTX PRO 6000 Blackwell (96 ГБ GDDR7). У наших AI-станціях є Quadro RTX 6000 — недорогий варіант з 24 ГБ — і RTX PRO 6000 Blackwell для найбільших моделей.
Чи потрібен потужний процесор для роботи з нейромережами?
Коли модель повністю у відеопам'яті, процесор майже не впливає на швидкість генерації, і для 1–2 карт вистачає Core Ultra або Ryzen 9. Threadripper PRO, Xeon W і EPYC потрібні для 3 карт (лінії PCIe), для вивантаження частини моделі в оперативну пам'ять (8 каналів) і для підготовки великих датасетів.
Яку операційну систему ставити: Windows чи Linux?
Ollama, LM Studio і ComfyUI працюють у Windows, а vLLM і більшість інструментів для навчання зручніше запускати в Linux, наприклад Ubuntu. Для перевірки на станції встановлено неактивовану Windows 10/11, її можна активувати своїм ключем або замінити на Linux.
Чи можна змінити конфігурацію і купити AI-станцію на компанію?
Так. Змінюємо обсяг пам'яті, кількість і модель відеокарт, процесор у межах платформи та накопичувачі — напишіть побажання в коментарі до замовлення або узгодьте з менеджером. Оплата на розрахунковий рахунок без комісії, безготівковий розрахунок з ПДВ або частинами від ПриватБанку та ПУМБ до 6 місяців, гарантія — 24 місяці.